


Coraz więcej zakupów nie zaczyna się już od strony z wynikami wyszukiwania. Ludzie pytają ChatGPT, Gemini czy Perplexity, gdzie coś kupić, i kierują się odpowiedzią. Każdy właściciel sklepu zadaje sobie wtedy pytanie, co trzeba w tym celu skonfigurować i czy w ogóle trzeba cokolwiek konfigurować.
Krótka odpowiedź brzmi: nie ma osobnej optymalizacji pod AI, ale o tym, czy sklep w ogóle może pojawić się w takiej odpowiedzi, decydują trzy rzeczy: czy asystent ma dostęp do stron, czy znalezione dane są aktualne i czy jest gotowy plik produktowy dla platform, które otwierają własną kasę. W tym artykule omawiamy, co na ten temat mówi dokumentacja Google i OpenAI oraz co warto sprawdzić już dziś.
Bez technicznego żargonuW skrócie: co sprawia, że sklep jest widoczny dla AI?
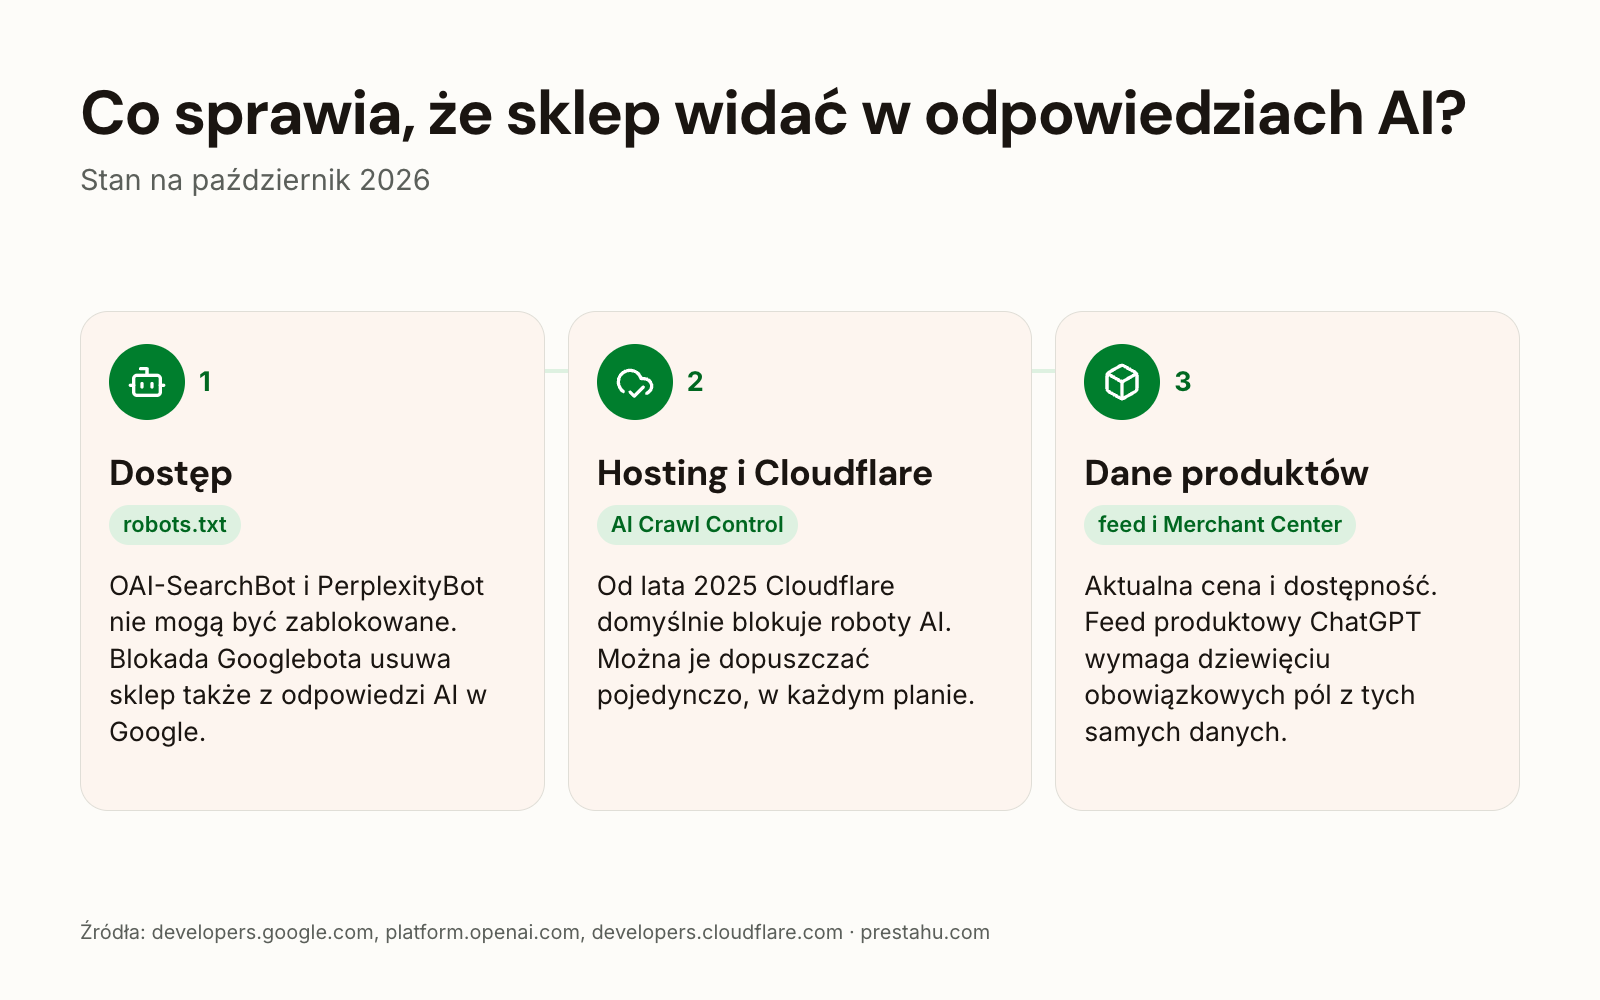
Asystenci AI nie wybierają z własnej listy. Czytają te same strony, które czytają wyszukiwarki, i przekazują pytającemu, co tam znaleźli. Jeśli strony sklepu są dostępne i aktualne, sklep może pojawić się w odpowiedzi. Jeśli coś nie wpuszcza programów, które je czytają, nie może.
Są dwa miejsca, w których przypadkiem zamyka się im drogę: plik robots.txt sklepu oraz ustawienia ochrony u firmy hostingowej lub w Cloudflare. Drugie zdarza się częściej, bo latem 2025 roku Cloudflare ustawił blokowanie robotów AI jako domyślne.
Nie chodzi więc o tworzenie nowych plików, tylko o sprawdzenie, czy nic nie blokuje dostępu. Odpowiedzieć na to mogą programista sklepu i firma hostingowa.
Pytania do programisty i firmy hostingowej
Czy plik robots.txt sklepu blokuje OAI-SearchBot lub PerplexityBot? Czy na koncie hostingowym lub w Cloudflare jest jakaś reguła blokująca roboty AI (AI Crawl Control, tryb walki z botami, reguła WAF)? Jeśli tak, których robotów dotyczy i od kiedy? Czy dane produktów w Google Merchant Center są aktualne, zwłaszcza cena i dostępność?
Czy odpowiedzi AI w Google wymagają osobnej optymalizacji?
Nie. Dokumentacja Google dla deweloperów mówi to wprost: nie ma dodatkowych wymagań, aby strona pojawiła się w Przeglądach od AI (AI Overviews) lub w trybie AI, i nie są potrzebne żadne specjalne optymalizacje. Na tej samej stronie dodano, że nie trzeba w tym celu tworzyć nowych plików do odczytu maszynowego, plików tekstowych dla AI ani znaczników, i że nie ma z tego powodu żadnych specjalnych danych strukturalnych schema.org do dodania.
Warunkiem jest natomiast to, aby strona była zindeksowana i mogła być wyświetlana z fragmentem w wyszukiwarce Google. Poza tym Google wymienia znane już praktyki, m.in. utrzymywanie danych strukturalnych zgodnie z tekstem widocznym na stronie oraz aktualnych informacji w Merchant Center.
Działa to też w drugą stronę, co jest ważniejsze: to, co wyklucza stronę z wyszukiwarki, wyklucza ją także z odpowiedzi AI. Według Google dostęp kontrolują dyrektywy robots.txt dla Googlebota, a to, co jest pokazywane ze strony, ograniczają ustawienia nosnippet, data-nosnippet, max-snippet i noindex. Dodany na wszelki wypadek nosnippet wyklucza więc sklep również z odpowiedzi AI.
Które roboty warto wpuścić?
W pliku robots.txt liczy się tylko to, co zostało wprost zablokowane; wszystko, o czym plik nie wspomina, jest dozwolone. Mimo to warto wiedzieć, do czego służy każdy robot, bo nie wszystkie mają cokolwiek wspólnego z wyświetlaniem.
| Robot | Czemu służy | Co oznacza blokada |
|---|---|---|
| OAI-SearchBot (OpenAI) | odpowiedzi wyszukiwania w ChatGPT | sklep nie pojawia się w odpowiedziach wyszukiwania ChatGPT |
| GPTBot (OpenAI) | trenowanie modeli | treści nie trafiają do trenowania; nie wpływa to na wyświetlanie w wyszukiwaniu |
| ChatGPT-User (OpenAI) | otwiera stronę, bo poprosił o to użytkownik | reguły robots.txt mogą nie obowiązywać, bo wizytę inicjuje człowiek |
| PerplexityBot | wyświetlanie i linkowanie w Perplexity | sklep nie pojawia się w odpowiedziach Perplexity |
| Googlebot | wyszukiwarka Google i jej odpowiedzi AI | sklep wypada z wyszukiwarki, a wraz z nią z odpowiedzi AI |
| Google-Extended | trenowanie i ugruntowanie (grounding) modeli Gemini | według Google nie wpływa na obecność w wyszukiwarce i nie jest czynnikiem rankingowym |
Dokumentacja OpenAI podaje, że ustawienia są od siebie niezależne: można zezwolić OAI-SearchBot ze względu na widoczność w wyszukiwaniu, a GPTBot dalej blokować. Po zmianie pliku wyszukiwanie ChatGPT uwzględnia ją po mniej więcej jednym dniu.
Czy firma hostingowa lub Cloudflare mogą blokować roboty AI?
To częstsza przyczyna i nie rozstrzyga się jej w sklepie. 1 lipca 2025 roku Cloudflare ogłosił zmianę ustawienia domyślnego na blokowanie robotów AI, chyba że płacą za treści. Funkcja nazywa się AI Crawl Control, jest dostępna we wszystkich planach, pokazuje, ile żądań wysyła każdy robot AI, i pozwala zezwalać na nie lub blokować je pojedynczo. Płatny dostęp (pay per crawl) jest na razie w zamkniętej wersji beta.
W praktyce oznacza to, że plik robots.txt sklepu może na wszystko zezwalać, a żądanie w ogóle nie dociera do sklepu, bo wcześniej odpowiedział Cloudflare. Wpis w robots.txt jest prośbą, a reguła Cloudflare egzekwowaniem, dlatego oba trzeba sprawdzić osobno. Zapora lub ochrona przed botami u firmy hostingowej może filtrować w ten sam sposób, a tam blokadę często powoduje ogólna reguła, a nie nazwa robota AI.
Jeśli sklep działa za Cloudflare, ekran AI Crawl Control pokazuje wiersz po wierszu, który robot został zablokowany. Służy to jednocześnie jako pomiar: robot, którego nie ma na liście, nawet nie próbował.
Jak produkty trafiają do odpowiedzi zakupowych ChatGPT?
Tu czytelna strona już nie wystarczy. OpenAI wymaga osobnego pliku produktowego, a jego dokumentacja podaje, że dodawanie plików produktowych w ChatGPT jest obecnie dostępne dla zatwierdzonych partnerów, na wniosek. Gdy więc ktoś twierdzi, że sklep można po prostu podłączyć do ChatGPT, warto wiedzieć, że nie jest to samoobsługowa rejestracja.
Struktura pliku jest jednak publiczna i warto się do niej przygotować, bo opiera się na tych samych danych, których wymaga Google Shopping. Wymaganych jest dziewięć pól: item_id, title, description, url, brand, seller_name, image_url, availability i price. Zalecany rytm to jeden pełny plik dziennie przesyłany jako plik, a zmiany w ciągu dnia wysyłane przez API; dane o promocjach można przekazywać tylko przez API.
Płatność zostaje po stronie sprzedawcy. Według dokumentacji OpenAI stan zamówienia w kasie i obsługa płatności odbywają się w systemach sprzedawcy, a OpenAI nie jest stroną sprzedaży (merchant of record). Sklep nie oddaje żadnej części transakcji, tylko staje się dostępny w jeszcze jednym miejscu.
Oznacza to, że dla sklepu, którego plik produktowy Google Shopping nie jest w porządku, następnym krokiem jest właśnie ten plik, a nie AI. Te same dane, te same błędy: brak marki, nieaktualna cena, błędna dostępność. Nasz moduł Product feed export tworzy pliki dla Google, Facebooka i TikToka z jednego źródła, a nasz artykuł o Merchant API omawia, co w tym roku zmieniło się po stronie Google.
Czy sklep potrzebuje pliku llms.txt?
Nie po to, aby się wyświetlać. Przytoczona wyżej dokumentacja Google mówi wprost, że nie trzeba tworzyć plików tekstowych dla AI, a żadna wyszukiwarka ani żaden asystent nie podają takiego pliku jako warunku. Duże serwisy z dokumentacją, w tym strony dla deweloperów OpenAI i Cloudflare, publikują taki plik, bo ułatwia on czytanie ich dokumentacji za pomocą narzędzia AI, ale nie jest to czynnik rankingowy ani warunek wyświetlania.
W czym pomaga, to co innego: plik daje uporządkowaną listę tego, co jest w sklepie, dzięki czemu łatwiej przewidzieć, co znajdzie program czytający stronę. Dla tych, którzy wolą nie prowadzić tej listy ręcznie, nasz moduł llms.txt generator utrzymuje ją w zgodzie z produktami, kategoriami i stronami informacyjnymi. Kolejności nie da się jednak odwrócić: jeśli roboty są zablokowane albo dane nieaktualne, ten plik nie pomoże.
Jak mierzyć ruch z odpowiedzi AI?
Kliknięcia z odpowiedzi AI w Google pojawiają się w raporcie skuteczności w Search Console, w typie wyszukiwania „Internet”, razem z pozostałymi kliknięciami z wyszukiwarki. Nie ma osobnego wiersza dla AI, więc Search Console nie powie, ile z nich pochodziło stamtąd.
Druga droga to własna analityka: odwiedzający przychodzący z usług AI mają jako stronę odsyłającą adres tej usługi, na przykład chatgpt.com lub perplexity.ai. Warto przygotować dla nich segment lub raport w Google Analytics 4, bo domyślnie giną w ogólnym ruchu z odesłań. Po stronie reklamowej nasz moduł ChatGPT Ads mierzy wyniki reklam wyświetlanych w ChatGPT, z przeglądarki i z serwera.
Nie warto natomiast podawać szacunkowego udziału zamówień pochodzących z odpowiedzi AI. Nie ma dziś danych, które sklep mógłby odczytać z własnych narzędzi na poparcie takiej liczby.
Co warto zrobić teraz?
- Otwórz plik
robots.txtpod adresem sklepu (/robots.txt) i poszukaj wpisówOAI-SearchBot,GPTBot,PerplexityBotiGoogle-Extended. Jeśli żaden z nich nie maDisallow, ta część jest w porządku. - Zapytaj firmę hostingową lub sprawdź Cloudflare, czy jakaś reguła blokuje roboty AI. W Cloudflare ekran AI Crawl Control pokazuje to robot po robocie.
- Sprawdź indeksowanie w Search Console, bo strona, która nie jest zindeksowana, nie może też pojawić się w odpowiedzi AI. Tu należy też omyłkowo pozostawiony
nosnippet. - Uporządkuj plik produktowy (cena, dostępność, marka, zdjęcie), bo te same dane służą zarówno Google Shopping, jak i plikowi dla ChatGPT.
- Skonfiguruj pomiar odesłań z usług AI w Google Analytics 4, aby mieć punkt odniesienia do porównań w kolejnych miesiącach.
Wszystko poza tym to praca nad treścią, i to ta sama, której zawsze wymagało pozycjonowanie: dokładne nazwy produktów, prawdziwe opisy, wypełnione atrybuty, dane strukturalne zgodne ze stroną. Nie potrzeba do tego żadnej nowej techniki.
Co zmienia wspólny sygnał zgody na trenowanie AI w pliku robots.txt?
30 października 2026 roku Google zapowiedział obsługę wspólnego sygnału w pliku robots.txt, dzięki któremu witryna jednym wpisem przekaże kilku dostawcom AI, czy zgadza się na wykorzystanie swoich treści do trenowania modeli. Sygnał powstał w grupie roboczej AIPREF przy IETF. Dokumentacja Google dotycząca robotów podaje, że zapis będzie miał postać user-agent: __usage_ai-training, a obsługa planowana jest na początek 2027 roku, razem z innymi dostawcami AI. Do tego czasu obowiązują dotychczasowe mechanizmy, więc w sklepie nie ma dziś nic do przestawiania, wystarczy podjąć decyzję.
Zgodnie z zapowiedzią sygnał będzie działał tak: jeśli witryna odmówi zgody na trenowanie wspólnym tokenem i nie wskaże osobno Google-Extended, Google zamierza odczytać to tak, jakby Google-Extended został zablokowany. Mechanizmy poszczególnych firm działają nadal obok, więc w jednym pliku zmieści się szeroka odmowa i wyjątek dla konkretnego dostawcy.
Decyzja ma dwie strony. Dokumentacja Google mówi, że Google-Extended nie wpływa na obecność witryny w wyszukiwarce Google i nie jest czynnikiem rankingowym, więc odmowa zgody na trenowanie nie usuwa sklepu z wyników. Zapowiedź z 30 października dodaje jednak, że witryny, które wprost zezwalają na Google-Extended, mogą pojawiać się w odpowiedziach i otrzymywać kliknięcia dzięki groundingowi w aplikacjach Gemini. Kto odmawia zgody na trenowanie, rezygnuje też z tych kliknięć.
Google zwraca uwagę, że propozycja jest zgodna z unijnym kodeksem postępowania dla dostawców modeli AI ogólnego przeznaczenia, powiązanym z rozporządzeniem o AI, które uznaje plik robots.txt za podstawowy sposób wyrażenia preferencji czytelnej maszynowo. Ostateczny kształt jest jeszcze omawiany w IETF, ale miejsce zapisu jest już ustalone.
W PrestaShopie plik robots.txt powstaje z panelu administracyjnego, a ponowne wygenerowanie zastępuje cały plik: dopisana ręcznie linia ginie w tym momencie. Jedna instalacja ma jeden plik, więc sklep działający na kilku domenach nie ustawi z panelu osobnej reguły dla każdej domeny. Aby linia została, musi ją wpisać moduł w chwili generowania pliku.
Najczęściej zadawane pytania
P: Jeśli zablokuję GPTBot, zniknę z odpowiedzi ChatGPT?
O: Nie. Dokumentacja OpenAI podaje, że ustawienia są niezależne: GPTBot zbiera dane do trenowania, a za widoczność w wyszukiwaniu odpowiada OAI-SearchBot. To zablokowanie tego drugiego usuwa stronę z odpowiedzi wyszukiwania ChatGPT.
P: Czy z powodu AI warto dodać znaczniki schema.org?
O: Według Google nie ma w tym celu żadnych specjalnych danych strukturalnych do dodania. W przypadku istniejących znaczników produktów warunkiem jest ich zgodność z tekstem widocznym na stronie.
P: Czy moje produkty można już dziś kupić w ChatGPT?
O: Dodanie pliku produktowego jest według dokumentacji OpenAI obecnie dostępne dla zatwierdzonych partnerów, na wniosek. Płatność odbywa się w systemach sprzedawcy, a OpenAI nie jest stroną sprzedaży.
P: Skąd mam wiedzieć, czy robot AI w ogóle odwiedził sklep?
O: Z dziennika dostępu na koncie hostingowym, wyszukując nazwę robota, albo z listy AI Crawl Control w Cloudflare. Robot, którego nigdzie nie ma, nawet nie próbował.
Źródła: Wyszukiwarka Google: funkcje AI a Twoja witryna, Google: popularne roboty (Google-Extended), OpenAI: boty, OpenAI Commerce: pierwsze kroki, OpenAI Commerce: specyfikacja pliku produktowego, OpenAI Commerce: kluczowe pojęcia, Perplexity: boty, Cloudflare: Content Independence Day, Cloudflare: AI Crawl Control, Google Search Central, 2026-10-30, Google: Google-Extended

