


Une part croissante des parcours d’achat ne commence plus sur une page de résultats. Les gens demandent à ChatGPT, Gemini ou Perplexity où acheter quelque chose, et suivent la réponse. Tout marchand se demande alors ce qu’il faut configurer pour cela, et s’il faut même configurer quoi que ce soit.
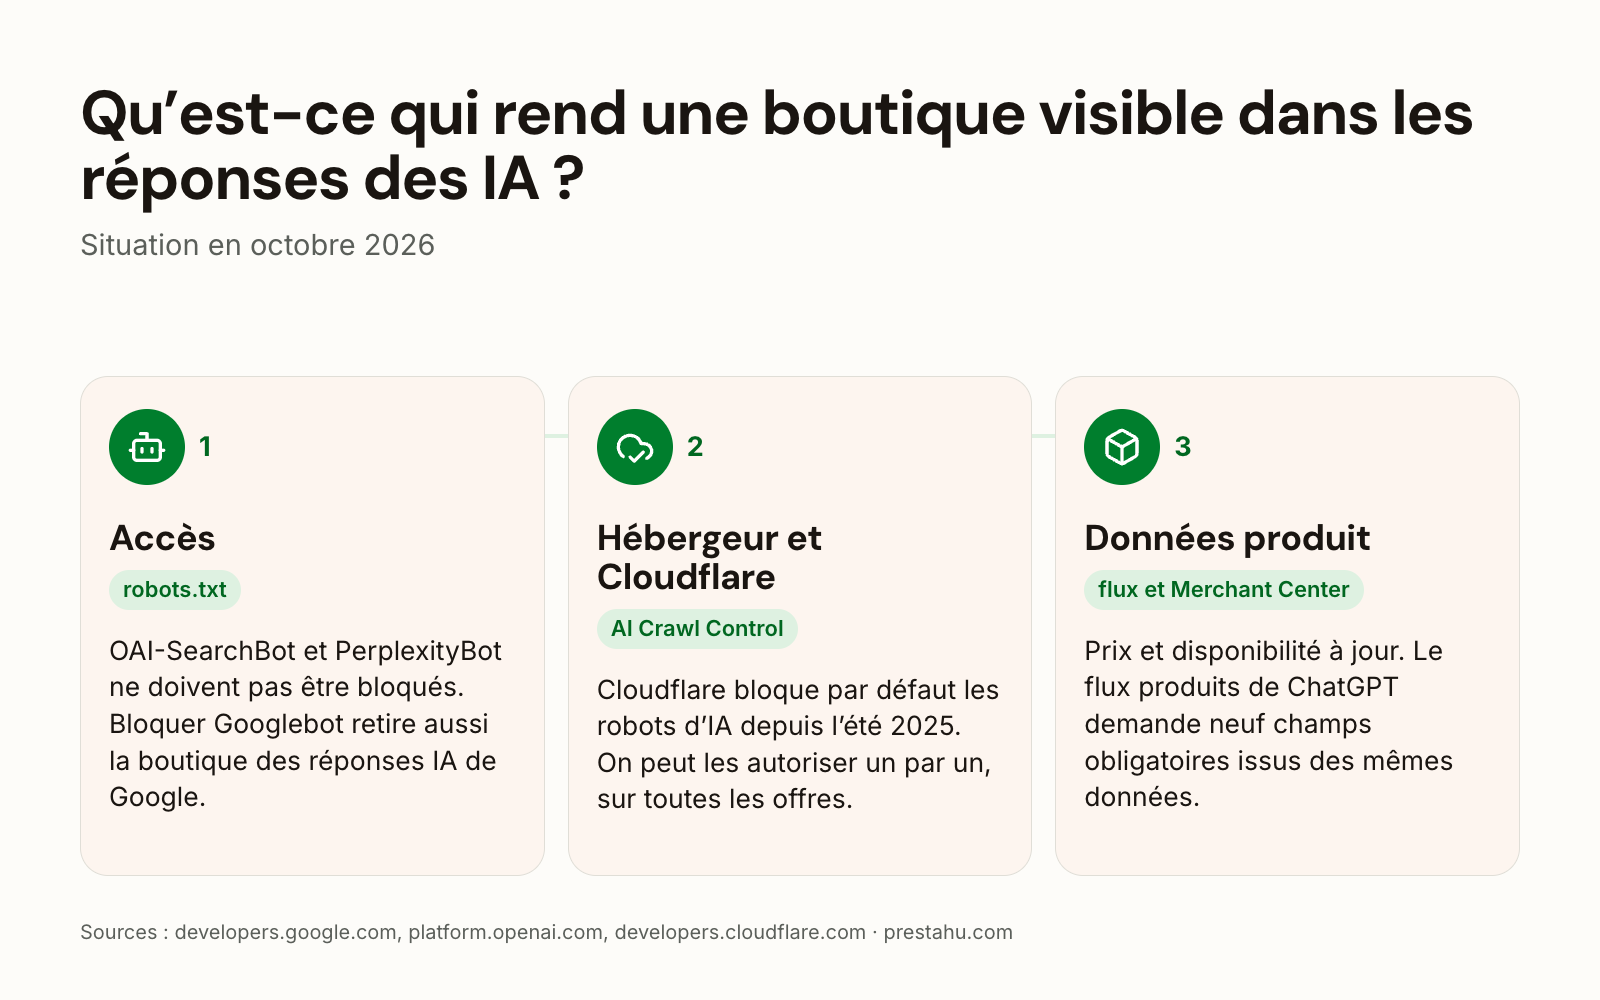
En résumé, il n’existe pas d’optimisation spécifique pour l’IA, mais trois éléments déterminent si une boutique peut seulement être citée dans une telle réponse : l’assistant a-t-il le droit d’accéder aux pages, les données qu’il y trouve sont-elles à jour, et un flux produits est-il prêt pour les plateformes qui ouvrent leur propre tunnel de paiement. Cet article reprend ce que la documentation de Google et d’OpenAI dit sur chacun de ces points, et ce qu’il vaut la peine de vérifier dès aujourd’hui.
Pas technicien ?En bref : qu’est-ce qui rend une boutique visible pour l’IA ?
Les assistants IA ne choisissent pas dans une liste qui leur serait propre. Ils lisent les mêmes pages que les moteurs de recherche, et ils racontent à la personne ce qu’ils y ont trouvé. Si les pages d’une boutique sont accessibles et à jour, la boutique peut apparaître dans une réponse. Si quelque chose empêche les programmes de lecture d’y accéder, elle ne le peut pas.
Il y a deux endroits où ils se retrouvent bloqués par accident : le fichier robots.txt de la boutique, et les réglages de protection de l’hébergeur ou de Cloudflare. Le second cas est le plus fréquent, car à l’été 2025 Cloudflare a fait du blocage des robots d’IA le réglage par défaut.
Il ne s’agit donc pas de produire de nouveaux fichiers, mais de vérifier que rien ne bloque. Le développeur de la boutique et l’hébergeur peuvent répondre à cette question.
Questions pour votre développeur et votre hébergeur
Le fichier robots.txt de la boutique interdit-il OAI-SearchBot ou PerplexityBot ? Existe-t-il, sur l’hébergement ou dans Cloudflare, une règle qui bloque les robots d’IA (AI Crawl Control, mode de lutte contre les bots, règle WAF) ? Si oui, quels robots concerne-t-elle, et depuis quand ? Les données produit de Google Merchant Center sont-elles à jour, en particulier le prix et la disponibilité ?
Faut-il une optimisation spécifique pour les réponses IA de Google ?
Non. La documentation pour les développeurs de Google le dit clairement : il n’y a aucune exigence supplémentaire pour qu’une page apparaisse dans les Aperçus IA ou le Mode IA, et aucune optimisation particulière n’est nécessaire. La même page ajoute qu’il n’est pas nécessaire de créer pour cela de nouveaux fichiers lisibles par machine, des fichiers texte pour l’IA ou un balisage, et qu’il n’y a pas de données structurées schema.org particulières à ajouter.
La condition est ailleurs : la page doit être indexée et pouvoir s’afficher avec un extrait dans la recherche Google. Au-delà, Google cite des pratiques déjà connues, parmi lesquelles la cohérence des données structurées avec le texte visible sur la page et la mise à jour des informations de Merchant Center.
L’inverse est vrai aussi, et c’est plus important : tout ce qui écarte une page de la recherche l’écarte aussi des réponses IA. Selon Google, ce sont les directives robots.txt pour Googlebot qui contrôlent l’accès, tandis que ce qui est affiché de la page est limité par les directives nosnippet, data-nosnippet, max-snippet et noindex. Un nosnippet ajouté par précaution exclut donc aussi la boutique des réponses IA.
Quels robots faut-il laisser entrer ?
Dans le robots.txt, seul ce qui est explicitement interdit compte ; tout ce que le fichier ne mentionne pas est autorisé. Il est tout de même utile de savoir à quoi sert chaque robot, car tous n’ont pas de lien avec l’affichage.
| Robot | À quoi il sert | Ce qu’implique un blocage |
|---|---|---|
| OAI-SearchBot (OpenAI) | les réponses de recherche de ChatGPT | la boutique n’apparaît pas dans les réponses de recherche de ChatGPT |
| GPTBot (OpenAI) | l’entraînement des modèles | le contenu est exclu de l’entraînement ; l’affichage dans la recherche n’est pas concerné |
| ChatGPT-User (OpenAI) | ouvre une page à la demande d’un utilisateur | les règles robots.txt peuvent ne pas s’appliquer, car la visite est déclenchée par une personne |
| PerplexityBot | la mise en avant et les liens dans Perplexity | la boutique n’apparaît pas dans les réponses de Perplexity |
| Googlebot | la recherche Google et ses réponses IA | la boutique disparaît de la recherche, et des réponses IA avec elle |
| Google-Extended | l’entraînement et l’ancrage des modèles Gemini | selon Google, sans effet sur l’inclusion dans la recherche, et ce n’est pas un critère de classement |
La documentation d’OpenAI précise que ces réglages sont indépendants : OAI-SearchBot peut être autorisé pour la visibilité dans la recherche tandis que GPTBot reste interdit. Après la modification du fichier, il faut environ un jour pour que la recherche de ChatGPT prenne le changement en compte.
L’hébergeur ou Cloudflare peut-il bloquer les robots d’IA ?
C’est la cause la plus fréquente, et elle ne se règle pas dans la boutique. Le 1er juillet 2025, Cloudflare a annoncé passer par défaut au blocage des robots d’IA, sauf s’ils paient pour le contenu. La fonction s’appelle AI Crawl Control ; elle est disponible dans toutes les offres, montre le volume de requêtes de chaque robot d’IA et permet de les autoriser ou de les bloquer un par un. L’accès payant, pay per crawl, est pour l’instant en bêta privée.
Concrètement, le robots.txt de la boutique peut tout autoriser alors que la requête n’atteint jamais la boutique, parce que Cloudflare a répondu avant. Une entrée robots.txt est une demande ; une règle Cloudflare est une contrainte effective, c’est pourquoi les deux doivent être vérifiés séparément. Un pare-feu ou une protection anti-bots chez l’hébergeur peut filtrer de la même manière, et le blocage y vient souvent d’une règle générale plutôt que du nom d’un robot d’IA.
Si la boutique est derrière Cloudflare, l’écran AI Crawl Control montre ligne par ligne quel robot a été bloqué. Il sert aussi de mesure : un robot absent de la liste n’a jamais essayé.
Comment les produits arrivent-ils dans les réponses d’achat de ChatGPT ?
À ce stade, une page lisible ne suffit plus. OpenAI demande un flux produits distinct, et sa documentation indique que l’intégration de flux produits dans ChatGPT est pour l’instant réservée à des partenaires approuvés, sur candidature. Quand on entend qu’une boutique peut simplement être branchée sur ChatGPT, il est donc utile de savoir qu’il ne s’agit pas d’une inscription en libre-service.
La structure du flux est en revanche publique, et il vaut la peine de s’y préparer, car elle repose sur les mêmes données que celles demandées par Google Shopping. Neuf champs sont obligatoires : item_id, title, description, url, brand, seller_name, image_url, availability et price. Le rythme recommandé est un flux complet par jour sous forme de fichier, les changements de la journée étant envoyés par l’API ; les données de promotions ne peuvent être transmises que par l’API.
Le paiement reste chez le marchand. Selon la documentation d’OpenAI, l’état du paiement et son traitement se déroulent sur les systèmes du marchand, et OpenAI n’est pas le vendeur officiel (merchant of record). La boutique ne cède aucune partie de la transaction ; elle devient seulement accessible sur un canal de plus.
Autrement dit, pour une boutique dont le flux Google Shopping n’est pas en ordre, la prochaine étape est ce flux, pas l’IA. Mêmes données, mêmes défauts : marque manquante, prix périmé, disponibilité erronée. Notre module Product feed export génère les flux Google, Facebook et TikTok à partir d’une seule source, et notre article sur la Merchant API explique ce qui a changé côté Google cette année.
Une boutique a-t-elle besoin d’un fichier llms.txt ?
Pas pour être affichée. La documentation de Google citée plus haut indique explicitement qu’il n’est pas nécessaire de créer des fichiers texte pour l’IA, et aucun moteur de recherche ni assistant n’en fait une condition dans sa documentation. De grands sites de documentation, dont les sites pour développeurs d’OpenAI et de Cloudflare, publient bien un tel fichier, parce qu’il rend leur propre documentation plus facile à lire avec un outil d’IA, mais ce n’est pas un critère de classement ni d’éligibilité.
Son utilité est ailleurs : le fichier donne une liste ordonnée de ce que contient la boutique, ce qui rend plus prévisible ce qu’un programme de lecture y trouve. Pour ceux qui préfèrent ne pas tenir cette liste à la main, notre module llms.txt generator la maintient en phase avec les produits, les catégories et les pages d’information. L’ordre ne peut toutefois pas être inversé : si les robots sont bloqués ou si les données sont périmées, ce fichier n’y changera rien.
Comment mesurer le trafic venant des réponses IA ?
Les clics provenant des réponses IA de Google apparaissent dans le rapport Performances de la Search Console, dans le type de recherche « Web », avec les autres clics de recherche. Il n’y a pas de ligne distincte pour l’IA : la Search Console ne permet donc pas de savoir combien de clics en viennent.
L’autre voie est votre propre outil d’analyse : les visiteurs qui arrivent depuis des surfaces d’IA portent le référent de cette surface, par exemple chatgpt.com ou perplexity.ai. Il est utile de créer pour eux un segment ou un rapport dans Google Analytics 4, car par défaut ils se fondent dans le trafic de référence général. Côté publicité, notre module ChatGPT Ads mesure les résultats des annonces diffusées dans ChatGPT, depuis le navigateur et depuis le serveur.
Une chose n’a pas de sens : avancer une estimation de la part des commandes venant des réponses IA. Aucune donnée qu’une boutique pourrait lire aujourd’hui sur ses propres outils ne permet d’étayer un tel chiffre.
Que faire dès maintenant ?
- Ouvrez le
robots.txtà l’adresse de la boutique (/robots.txt) et recherchezOAI-SearchBot,GPTBot,PerplexityBotetGoogle-Extended. Si aucun n’a deDisallow, ce point est en ordre. - Interrogez l’hébergeur ou vérifiez Cloudflare : une règle bloque-t-elle les robots d’IA ? Sur Cloudflare, l’écran AI Crawl Control l’indique robot par robot.
- Vérifiez l’indexation dans la Search Console, car une page non indexée ne peut pas non plus apparaître dans une réponse IA. Un
nosnippetlaissé par erreur relève aussi de ce point. - Mettez le flux produits en ordre (prix, disponibilité, marque, image), car les mêmes données servent à Google Shopping comme à un flux ChatGPT.
- Mettez en place la mesure des visites venant des surfaces d’IA dans Google Analytics 4, pour disposer d’une base de comparaison dans les mois à venir.
Le reste relève du travail sur le contenu, et c’est le même que celui que le référencement a toujours demandé : des noms de produits exacts, de vraies descriptions, des attributs renseignés, des données structurées conformes à la page. Aucune nouvelle technique n’est nécessaire pour cela.
Qu'est-ce que change le signal commun d'entraînement de l'IA dans le robots.txt ?
Le 30 octobre 2026, Google a annoncé qu'il prendra en charge dans le robots.txt un signal commun permettant à un site d'indiquer en une seule fois, à plusieurs fournisseurs d'IA, s'il accepte que son contenu serve à l'entraînement. Ce signal est issu des travaux du groupe AIPREF de l'IETF. La documentation de Google sur ses robots précise qu'il s'écrira user-agent: __usage_ai-training et que la prise en charge est prévue pour le début de 2027, en même temps que celle d'autres fournisseurs d'IA. D'ici là, les contrôles actuels restent valables : il n'y a donc rien à modifier aujourd'hui dans la boutique, il suffit de trancher la question.
Selon l'annonce, le fonctionnement sera le suivant : si un site refuse l'entraînement au moyen du jeton commun sans mentionner séparément Google-Extended, Google compte interpréter ce refus comme si Google-Extended avait été interdit. Les contrôles propres à chaque entreprise continuent de fonctionner à côté, ce qui permet de réunir dans un même fichier un refus large et une exception pour un fournisseur précis.
La décision a deux faces. La documentation de Google indique que Google-Extended n'a aucune incidence sur la présence du site dans la recherche Google et n'est pas un facteur de classement : refuser l'entraînement ne fait donc pas disparaître la boutique des résultats. L'annonce du 30 octobre précise en revanche que les sites qui autorisent explicitement Google-Extended peuvent apparaître dans les réponses et recevoir des clics grâce au grounding dans les applications Gemini. Refuser l'entraînement, c'est aussi renoncer à ces clics.
Google ajoute que la proposition est conforme au code de bonnes pratiques de l'Union européenne destiné aux fournisseurs de modèles d'IA à usage général, dans le cadre du règlement sur l'IA, qui reconnaît le robots.txt comme le principal moyen d'exprimer une préférence lisible par une machine. La forme définitive se discute encore à l'IETF, mais l'emplacement du fichier est déjà fixé.
Dans PrestaShop, le fichier robots.txt est écrit depuis l'administration, et sa régénération remplace l'intégralité du fichier : une ligne ajoutée à la main disparaît à ce moment-là. Une installation ne possède qu'un seul fichier, si bien qu'une boutique répartie sur plusieurs domaines ne peut pas définir depuis l'administration une règle différente par domaine. Pour que la ligne reste en place, c'est un module qui doit l'écrire au moment de la génération.
Questions fréquentes
Q : Si j’interdis GPTBot, est-ce que je disparais des réponses de ChatGPT ?
R : Non. La documentation d’OpenAI précise que les réglages sont indépendants : GPTBot collecte pour l’entraînement, tandis que la visibilité dans la recherche relève d’OAI-SearchBot. C’est l’interdiction de ce dernier qui retire un site des réponses de recherche de ChatGPT.
Q : Faut-il ajouter un balisage schema.org à cause de l’IA ?
R : Selon Google, il n’y a pas de données structurées particulières à ajouter pour cela. Pour le balisage produit existant, la condition est qu’il corresponde au texte visible sur la page.
Q : Mes produits peuvent-ils être achetés dans ChatGPT dès aujourd’hui ?
R : Selon la documentation d’OpenAI, l’intégration d’un flux produits est pour l’instant réservée à des partenaires approuvés, sur candidature. Le paiement se fait sur les systèmes du marchand, et OpenAI n’est pas le vendeur officiel.
Q : Comment savoir si un robot d’IA est seulement venu ?
R : Dans le journal d’accès de l’hébergement, en recherchant le nom du robot, ou dans la liste AI Crawl Control de Cloudflare. Un robot qui n’apparaît nulle part n’a jamais essayé.
Sources : Recherche Google : les fonctionnalités d’IA et votre site, Google : robots d’exploration courants (Google-Extended), OpenAI : robots, OpenAI Commerce : premiers pas, OpenAI Commerce : spécification du flux produits, OpenAI Commerce : notions clés, Perplexity : robots, Cloudflare : « Content Independence Day », Cloudflare : AI Crawl Control, Google Search Central, 2026-10-30, Google: Google-Extended

