


Una parte cada vez mayor de los procesos de compra ya no empieza en una página de resultados. La gente pregunta a ChatGPT, Gemini o Perplexity dónde comprar algo y actúa según la respuesta. La pregunta que se hace entonces cualquier propietario de una tienda es qué hay que configurar para ello, y si hay que configurar algo.
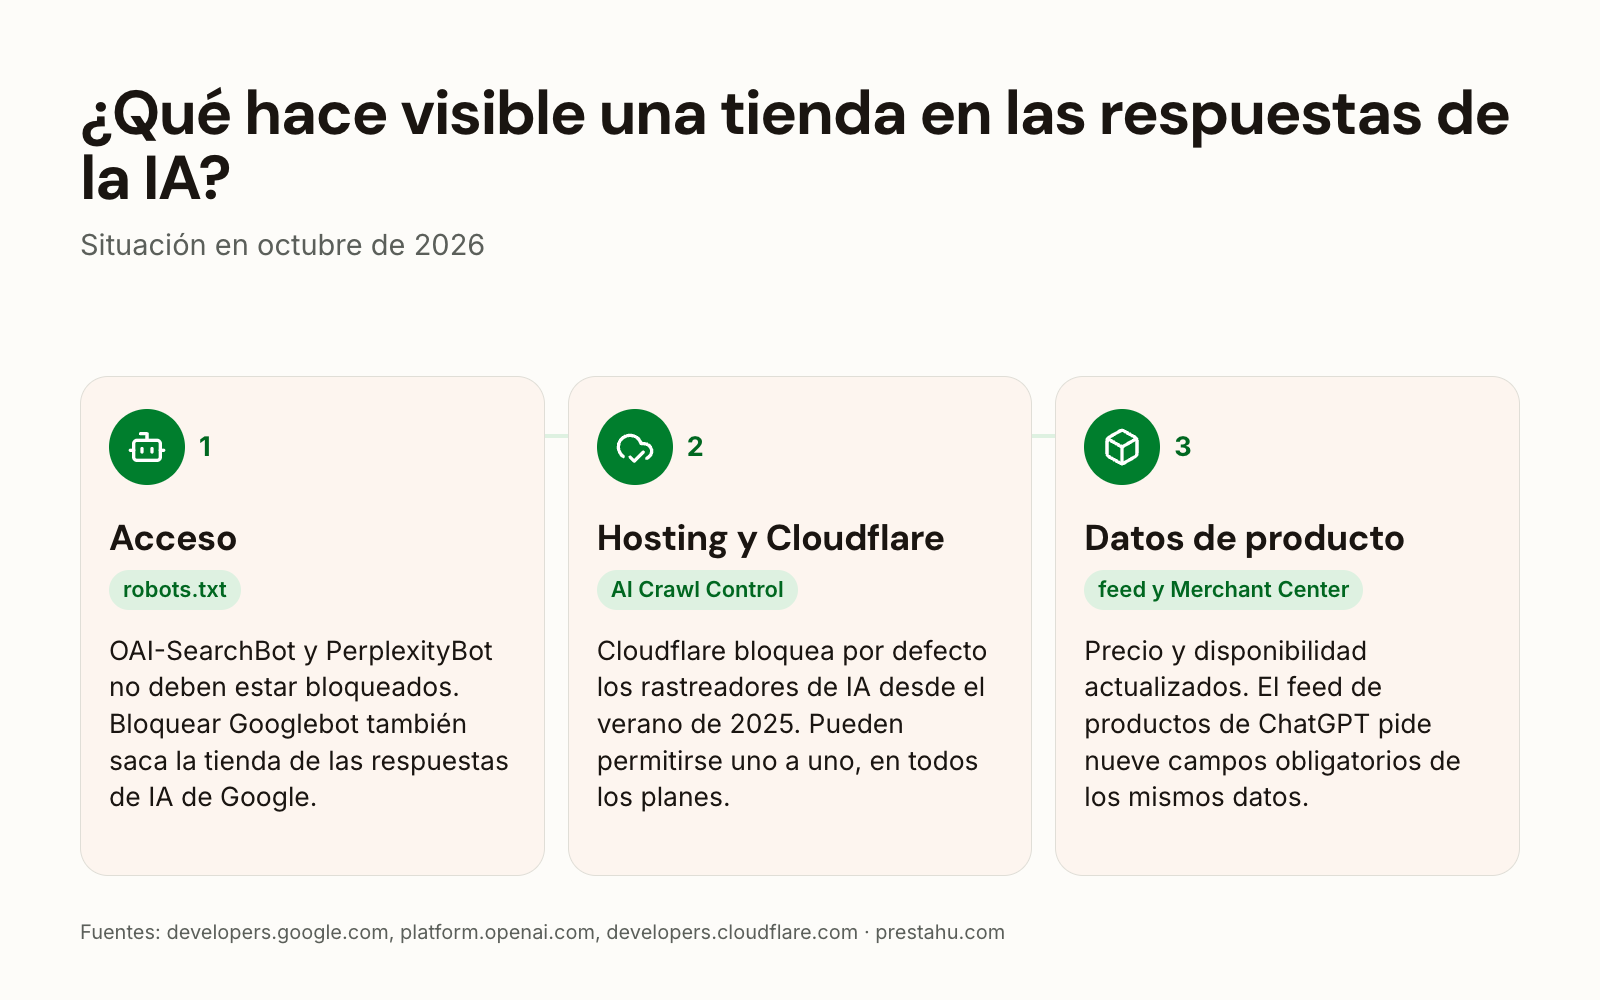
La respuesta corta es que no existe una optimización específica para la IA, pero hay tres cosas que deciden si una tienda puede siquiera aparecer en una respuesta así: si el asistente puede acceder a las páginas, si los datos que encuentra están actualizados y si hay un feed de productos preparado para las plataformas que abren su propio proceso de pago. Este artículo repasa lo que dice sobre cada una la documentación de Google y de OpenAI, y qué conviene comprobar hoy.
¿No es usted técnico?En resumen: ¿qué hace que una tienda sea visible para la IA?
Los asistentes de IA no eligen de una lista propia. Leen las mismas páginas que leen los buscadores y cuentan a la persona lo que han encontrado en ellas. Si las páginas de una tienda son accesibles y están actualizadas, la tienda puede aparecer en una respuesta. Si algo impide el paso a los programas que leen las páginas, no.
Hay dos sitios en los que se les bloquea por descuido: el archivo robots.txt de la tienda y la configuración de protección del proveedor de alojamiento o de Cloudflare. El segundo es el más habitual, porque en el verano de 2025 Cloudflare pasó a bloquear por defecto los rastreadores de IA.
Por tanto, lo que hay que hacer no es crear archivos nuevos, sino comprobar que nada esté bloqueando. El desarrollador de la tienda y el proveedor de alojamiento pueden responderlo.
Preguntas para su desarrollador y su proveedor de alojamiento
¿Bloquea el robots.txt de la tienda a OAI-SearchBot o a PerplexityBot? ¿Hay alguna regla en la cuenta de alojamiento o en Cloudflare que bloquee los rastreadores de IA (AI Crawl Control, el modo de lucha contra bots, una regla del WAF)? En ese caso, ¿a qué rastreadores afecta y desde cuándo? ¿Están actualizados los datos de producto en Google Merchant Center, en particular el precio y la disponibilidad?
¿Hace falta una optimización específica para las respuestas de IA de Google?
No. La documentación para desarrolladores de Google lo dice claramente: no hay requisitos adicionales para que una página aparezca en AI Overviews o en el Modo IA, y no se necesitan optimizaciones especiales. La misma página añade que no hace falta crear para ello nuevos archivos legibles por máquina, archivos de texto para IA ni marcado, y que no hay datos estructurados especiales de schema.org que añadir por este motivo.
Lo que sí es una condición: la página tiene que estar indexada y poder mostrarse con un fragmento en la Búsqueda de Google. Más allá de eso, Google enumera prácticas ya conocidas, entre ellas mantener los datos estructurados en línea con el texto visible en la página y mantener actualizada la información de Merchant Center.
También se cumple lo contrario, y es más importante: lo que impide que una página aparezca en la Búsqueda también la deja fuera de las respuestas de IA. Según Google, las directivas de robots.txt para Googlebot controlan el acceso, mientras que lo que se muestra de la página lo limitan los controles nosnippet, data-nosnippet, max-snippet y noindex. Un nosnippet añadido por precaución deja, por tanto, a la tienda también fuera de las respuestas de IA.
¿Qué rastreadores conviene dejar pasar?
En robots.txt solo cuenta lo que se bloquea expresamente; todo lo que el archivo no menciona está permitido. Aun así, conviene saber para qué sirve cada rastreador, porque no todos tienen que ver con aparecer en las respuestas.
| Rastreador | Para qué sirve | Qué supone bloquearlo |
|---|---|---|
| OAI-SearchBot (OpenAI) | respuestas de búsqueda de ChatGPT | la tienda no aparece en las respuestas de búsqueda de ChatGPT |
| GPTBot (OpenAI) | entrenamiento de modelos | el contenido queda fuera del entrenamiento; la aparición en la búsqueda no se ve afectada |
| ChatGPT-User (OpenAI) | abre una página porque un usuario lo ha pedido | puede que no se apliquen las reglas de robots.txt, porque la visita la inicia una persona |
| PerplexityBot | aparecer y ser enlazado en Perplexity | la tienda no aparece en las respuestas de Perplexity |
| Googlebot | la Búsqueda de Google y sus respuestas de IA | la tienda desaparece de la Búsqueda y, con ello, de las respuestas de IA |
| Google-Extended | entrenamiento y fundamentación (grounding) de los modelos Gemini | según Google, no afecta a la inclusión en la Búsqueda ni es un factor de posicionamiento |
La documentación de OpenAI indica que los ajustes son independientes entre sí: se puede permitir OAI-SearchBot por la visibilidad en la búsqueda y mantener bloqueado GPTBot. Después de editar el archivo, la búsqueda de ChatGPT tarda alrededor de un día en tener en cuenta el cambio.
¿Puede estar bloqueando los rastreadores de IA el alojamiento o Cloudflare?
Es la causa más habitual, y no se decide dentro de la tienda. El 1 de julio de 2025, Cloudflare anunció que cambiaba la configuración por defecto para bloquear los rastreadores de IA salvo que paguen por el contenido. La función se llama AI Crawl Control, está disponible en todos los planes, muestra cuántas peticiones hace cada rastreador de IA y permite o bloquea cada uno por separado. El acceso de pago, pay per crawl, está de momento en beta privada.
En la práctica, esto significa que el robots.txt de la tienda puede permitirlo todo mientras la petición ni siquiera llega a la tienda, porque Cloudflare ha respondido antes. Una entrada de robots.txt es una petición; una regla de Cloudflare es una imposición, y por eso hay que comprobar ambas por separado. Un cortafuegos o una protección contra bots del proveedor de alojamiento puede filtrar de la misma manera, y ahí el bloqueo suele deberse a una regla general más que al nombre de un rastreador de IA.
Si la tienda está detrás de Cloudflare, la pantalla de AI Crawl Control muestra fila por fila qué rastreador se bloqueó. Esto sirve a la vez de medición: un rastreador que no aparece en la lista no lo ha intentado nunca.
¿Cómo llegan los productos a las respuestas de compra de ChatGPT?
Aquí ya no basta con una página legible. OpenAI pide un feed de productos independiente, y su documentación indica que la incorporación de feeds de productos en ChatGPT está disponible actualmente para socios aprobados, previa solicitud. Así que, cuando alguien afirme que una tienda puede conectarse sin más a ChatGPT, conviene saber que no se trata de un alta por cuenta propia.
La estructura del feed, en cambio, es pública, y merece la pena prepararse, porque se construye con los mismos datos que pide Google Shopping. Hay nueve campos obligatorios: item_id, title, description, url, brand, seller_name, image_url, availability y price. El ritmo recomendado es un feed completo al día como subida de archivo, con los cambios a lo largo del día enviados por la API; los datos de promociones solo pueden enviarse por la API.
El pago sigue en manos del comerciante. Según la documentación de OpenAI, el estado del proceso de pago y el procesamiento del pago se gestionan en los sistemas del comerciante, y OpenAI no es el vendedor que figura en la transacción (merchant of record). Una tienda no cede ninguna parte de la transacción; solo pasa a estar accesible en un canal más.
Lo que significa que, para una tienda cuyo feed de Google Shopping no está en orden, el siguiente paso es ese feed, no la IA. Los mismos datos, los mismos fallos: marca que falta, precio desactualizado, disponibilidad incorrecta. Nuestro módulo Exportación de feeds de productos genera los feeds de Google, Facebook y TikTok desde una sola fuente, y nuestro artículo sobre la Merchant API explica qué ha cambiado este año por parte de Google.
¿Necesita una tienda un archivo llms.txt?
No para aparecer en las respuestas. La documentación de Google citada antes dice expresamente que no hace falta crear archivos de texto para IA, y ningún buscador ni asistente documenta uno como condición. Grandes sitios de documentación, entre ellos los sitios para desarrolladores de OpenAI y Cloudflare, sí publican un archivo así, porque facilita la lectura de su propia documentación con una herramienta de IA, pero no es un factor de posicionamiento ni de elegibilidad.
Ayuda en otra cosa: el archivo ofrece una lista ordenada de lo que contiene la tienda, lo que hace más previsible lo que encuentra un programa que la lee. Para quien prefiera no mantener esa lista a mano, nuestro módulo Generador de llms.txt la mantiene sincronizada con los productos, las categorías y las páginas informativas. Pero el orden no puede invertirse: si los rastreadores están bloqueados o los datos están desactualizados, este archivo no servirá de nada.
¿Cómo se mide el tráfico que llega desde las respuestas de IA?
Los clics procedentes de las respuestas de IA de Google aparecen en el informe de rendimiento de Search Console, dentro del tipo de búsqueda «Web», junto con el resto de los clics de búsqueda. No hay una fila aparte para la IA, así que Search Console no puede decirle cuántos llegaron desde ahí.
La otra vía es su propia analítica: los visitantes que llegan desde canales de IA traen el referente de ese canal, por ejemplo chatgpt.com o perplexity.ai. Conviene crear un segmento o un informe para ellos en Google Analytics 4, porque por defecto se diluyen en el tráfico de referencia general. En la parte publicitaria, nuestro módulo ChatGPT Ads mide los resultados de los anuncios que se publican en ChatGPT, desde el navegador y desde el servidor.
Lo que no merece la pena es citar una estimación de la proporción de pedidos que llegan desde respuestas de IA. Hoy no hay datos que una tienda pueda leer en sus propios canales para respaldar una cifra así.
¿Qué conviene hacer ahora?
- Abrir
robots.txten la propia dirección de la tienda (/robots.txt) y buscarOAI-SearchBot,GPTBot,PerplexityBotyGoogle-Extended. Si ninguno tiene unDisallow, esta parte está en orden. - Preguntar al proveedor de alojamiento o revisar Cloudflare por si alguna regla bloquea los rastreadores de IA. En Cloudflare, la pantalla de AI Crawl Control lo muestra rastreador por rastreador.
- Comprobar la indexación en Search Console, porque una página que no está indexada tampoco puede aparecer en una respuesta de IA. Un
nosnippetque se haya quedado por error también entra aquí. - Poner en orden el feed de productos (precio, disponibilidad, marca, imagen), porque los mismos datos sirven tanto para Google Shopping como para un feed de ChatGPT.
- Configurar la medición en Google Analytics 4 para las visitas desde canales de IA, de modo que haya una referencia con la que comparar en los próximos meses.
Todo lo demás es trabajo de contenido, y es el mismo trabajo que siempre ha pedido el posicionamiento en buscadores: nombres de producto precisos, descripciones reales, atributos completos y datos estructurados que coincidan con la página. No hace falta ninguna técnica nueva para ello.
¿Qué cambia la señal común de entrenamiento de IA en el robots.txt?
El 30 de octubre de 2026 Google anunció que admitirá en el robots.txt una señal común con la que un sitio puede indicar de una sola vez, a varios proveedores de IA, si permite que su contenido se utilice para entrenar modelos. La señal procede del trabajo del grupo AIPREF del IETF. La documentación de Google sobre sus rastreadores indica que se escribirá como user-agent: __usage_ai-training y que la compatibilidad está prevista para principios de 2027, junto con la de otros proveedores de IA. Hasta entonces siguen vigentes los controles actuales, así que hoy no hay nada que cambiar en la tienda: basta con tomar la decisión.
Según el anuncio, la señal funcionará así: si un sitio rechaza el entrenamiento mediante el token común y no menciona Google-Extended por separado, Google prevé interpretarlo como si Google-Extended estuviera bloqueado. Los controles propios de cada empresa siguen funcionando en paralelo, de modo que en un mismo archivo caben un rechazo amplio y una excepción para un proveedor concreto.
La decisión tiene dos caras. La documentación de Google señala que Google-Extended no afecta a la presencia del sitio en la Búsqueda de Google ni es un factor de posicionamiento, por lo que rechazar el entrenamiento no retira la tienda de los resultados. El anuncio del 30 de octubre añade, en cambio, que los sitios que permiten expresamente Google-Extended pueden aparecer en las respuestas y recibir clics a través del grounding en las aplicaciones de Gemini. Quien rechaza el entrenamiento renuncia también a esos clics.
Google apunta además que la propuesta es coherente con el código de buenas prácticas de la Unión Europea para proveedores de modelos de IA de uso general, en el marco del Reglamento de IA, que reconoce el robots.txt como vía principal para expresar una preferencia legible por máquinas. La forma definitiva se sigue discutiendo en el IETF, pero el lugar del archivo ya está decidido.
En PrestaShop el archivo robots.txt se escribe desde la administración, y al regenerarlo se sustituye el archivo completo: la línea añadida a mano se pierde en ese momento. Una instalación tiene un único archivo, así que una tienda repartida en varios dominios no puede fijar desde la administración una regla distinta para cada dominio. Para que la línea permanezca, tiene que escribirla un módulo en el momento de la generación.
Preguntas frecuentes
P: Si bloqueo GPTBot, ¿desaparezco de las respuestas de ChatGPT?
R: No. La documentación de OpenAI indica que los ajustes son independientes: GPTBot recopila para el entrenamiento, mientras que de la visibilidad en la búsqueda se encarga OAI-SearchBot. Bloquear este último es lo que retira un sitio de las respuestas de búsqueda de ChatGPT.
P: ¿Hay que añadir marcado de schema.org por la IA?
R: Según Google, no hay datos estructurados especiales que añadir para ello. En el marcado de producto existente, la condición es que coincida con el texto visible en la página.
P: ¿Se pueden comprar hoy mis productos dentro de ChatGPT?
R: Según la documentación de OpenAI, la incorporación de un feed de productos está disponible actualmente para socios aprobados, previa solicitud. El pago se realiza en los sistemas del comerciante, y OpenAI no es el vendedor que figura en la transacción.
P: ¿Cómo sé si un rastreador de IA ha visitado la tienda?
R: Por el registro de accesos de la cuenta de alojamiento, buscando el nombre del rastreador, o por la lista de AI Crawl Control en Cloudflare. Un rastreador que no aparece en ningún sitio no lo ha intentado nunca.
Fuentes: Búsqueda de Google: las funciones de IA y su sitio web (en inglés), Google: rastreadores comunes (Google-Extended), OpenAI: bots, OpenAI Commerce: primeros pasos, OpenAI Commerce: especificación del feed de productos, OpenAI Commerce: conceptos clave, Perplexity: bots, Cloudflare: Content Independence Day, Cloudflare: AI Crawl Control, Google Search Central, 2026-10-30, Google: Google-Extended

