


Una quota crescente dei percorsi d'acquisto non parte più da una pagina di risultati. Le persone chiedono a ChatGPT, Gemini o Perplexity dove comprare qualcosa, e agiscono in base alla risposta. A quel punto chi gestisce un negozio online si chiede cosa vada configurato per questo, e se ci sia davvero qualcosa da configurare.
La risposta breve è che non esiste un'ottimizzazione separata per l'IA, ma tre cose decidono se un negozio può anche solo essere citato in una risposta del genere: se l'assistente può raggiungere le pagine, se i dati che trova sono aggiornati e se c'è un feed dei prodotti pronto per le piattaforme che aprono un proprio checkout. In questo articolo vediamo cosa dice su ciascun punto la documentazione di Google e di OpenAI, e cosa conviene controllare oggi.
Non sei un tecnico?In breve: cosa rende un negozio visibile all'IA?
Gli assistenti IA non scelgono da un proprio elenco. Leggono le stesse pagine che leggono i motori di ricerca e riferiscono alla persona quello che vi hanno trovato. Se le pagine di un negozio sono raggiungibili e aggiornate, il negozio può comparire in una risposta. Se qualcosa tiene fuori i programmi che leggono le pagine, non può.
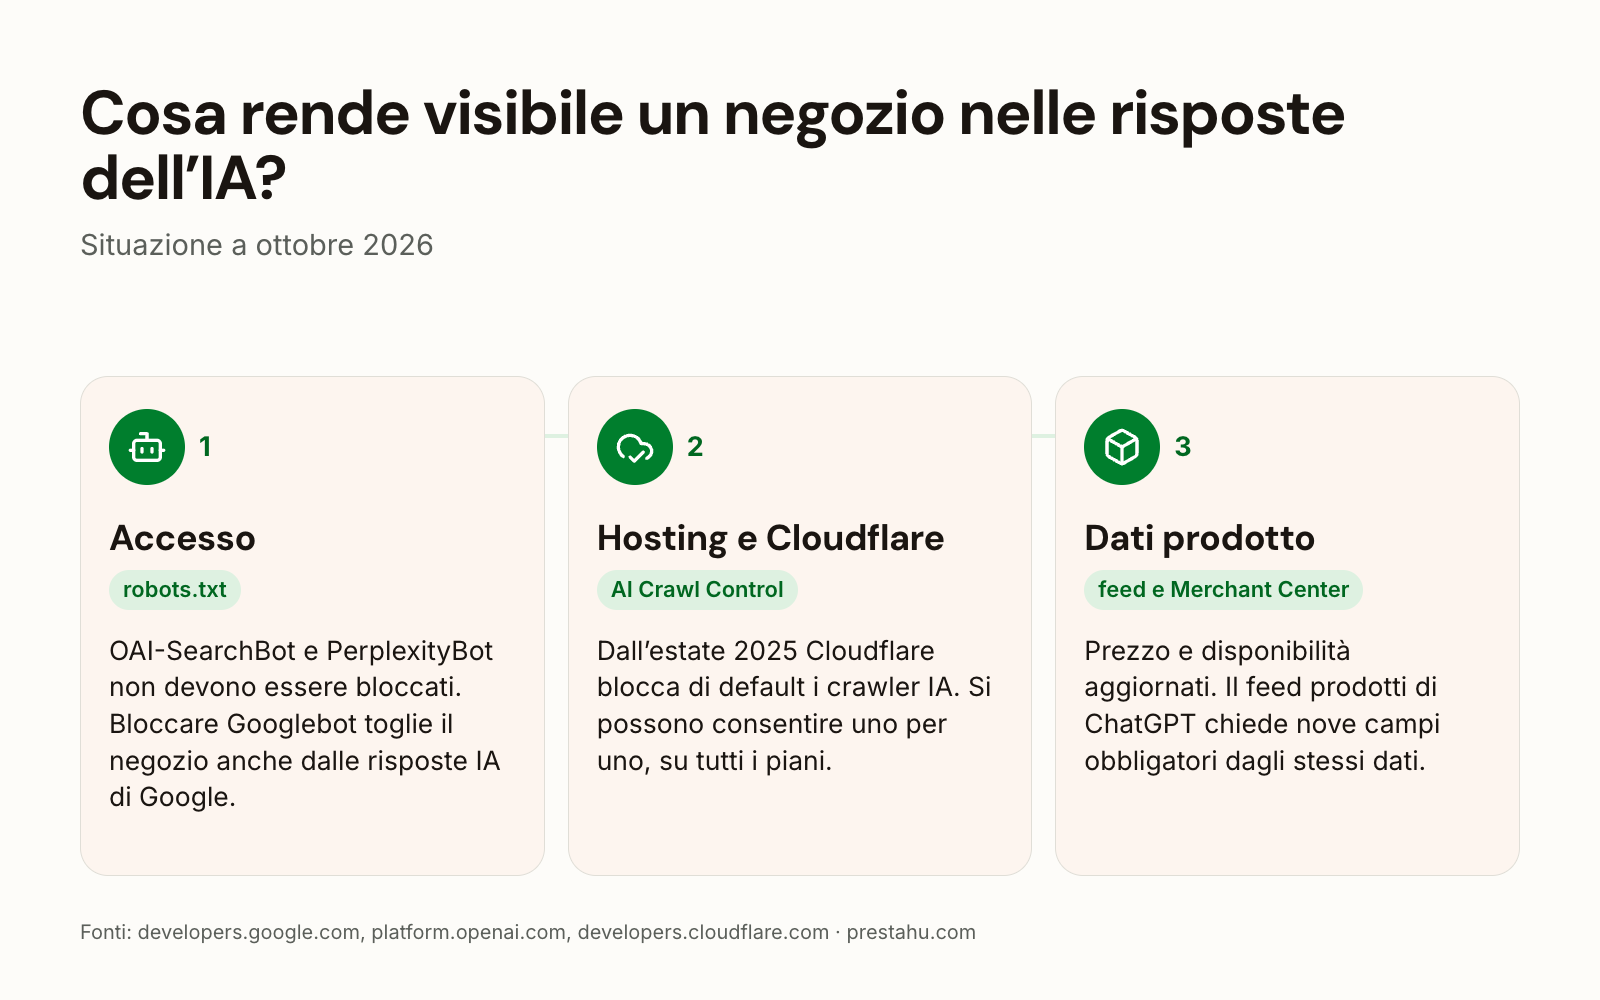
Ci sono due punti in cui vengono esclusi per sbaglio: il file robots.txt del negozio e le impostazioni di protezione del provider di hosting o di Cloudflare. Il secondo caso è il più frequente, perché nell'estate del 2025 Cloudflare ha reso predefinito il blocco dei crawler IA.
Quindi non serve produrre nuovi file, ma verificare che nulla stia bloccando. Possono rispondere lo sviluppatore del negozio e il provider di hosting.
Domande per lo sviluppatore e per l'hosting
Il robots.txt del negozio blocca OAI-SearchBot o PerplexityBot? Sull'account di hosting o in Cloudflare c'è una regola che blocca i crawler IA (AI Crawl Control, bot fight mode, una regola WAF)? Se sì, quali crawler riguarda e da quando? I dati dei prodotti in Google Merchant Center sono aggiornati, in particolare prezzo e disponibilità?
Serve un'ottimizzazione separata per le risposte IA di Google?
No. La documentazione per sviluppatori di Google lo dice chiaramente: non ci sono requisiti aggiuntivi perché una pagina compaia nelle AI Overview o in AI Mode, e non servono ottimizzazioni particolari. La stessa pagina aggiunge che per questo non occorre creare nuovi file leggibili da macchina, file di testo per l'IA o markup, e che non ci sono dati strutturati schema.org speciali da aggiungere.
La condizione è un'altra: la pagina deve essere indicizzata e idonea a essere mostrata con uno snippet nella Ricerca Google. Oltre a questo, Google elenca pratiche già note, tra cui mantenere i dati strutturati coerenti con il testo visibile nella pagina e tenere aggiornate le informazioni in Merchant Center.
Vale anche il contrario, ed è più importante: ciò che tiene una pagina fuori dalla Ricerca la tiene fuori anche dalle risposte IA. Secondo Google, l'accesso si controlla con le direttive del robots.txt per Googlebot, mentre ciò che viene mostrato della pagina è limitato dai controlli nosnippet, data-nosnippet, max-snippet e noindex. Un nosnippet aggiunto per prudenza esclude quindi il negozio anche dalle risposte IA.
Quali crawler conviene far entrare?
Nel robots.txt conta solo ciò che è vietato in modo esplicito; tutto ciò che il file non cita è consentito. Conviene comunque sapere a cosa serve ciascun crawler, perché non tutti hanno a che fare con la visibilità.
| Crawler | A cosa serve | Cosa comporta un blocco |
|---|---|---|
| OAI-SearchBot (OpenAI) | risposte di ricerca di ChatGPT | il negozio non compare nelle risposte di ricerca di ChatGPT |
| GPTBot (OpenAI) | addestramento dei modelli | i contenuti restano fuori dall'addestramento; la visibilità nella ricerca non cambia |
| ChatGPT-User (OpenAI) | apre una pagina su richiesta di un utente | le regole del robots.txt potrebbero non applicarsi, perché la visita parte da una persona |
| PerplexityBot | comparire ed essere linkati in Perplexity | il negozio non compare nelle risposte di Perplexity |
| Googlebot | Ricerca Google e le sue risposte IA | il negozio esce dalla Ricerca e, con essa, dalle risposte IA |
| Google-Extended | addestramento e grounding dei modelli Gemini | secondo Google non incide sull'inclusione nella Ricerca e non è un fattore di ranking |
La documentazione di OpenAI precisa che le impostazioni sono indipendenti tra loro: si può consentire OAI-SearchBot per la visibilità nella ricerca e continuare a vietare GPTBot. Dopo la modifica del file, la ricerca di ChatGPT recepisce il cambiamento in circa un giorno.
L'hosting o Cloudflare potrebbero bloccare i crawler IA?
È la causa più frequente, e non si decide all'interno del negozio. Il 1° luglio 2025 Cloudflare ha annunciato che avrebbe reso predefinito il blocco dei crawler IA, a meno che non paghino per i contenuti. La funzione si chiama AI Crawl Control, è disponibile in tutti i piani, mostra quante richieste fa ciascun crawler IA e permette di consentirli o bloccarli uno per uno. L'accesso a pagamento, pay per crawl, per ora è in beta privata.
In pratica il robots.txt del negozio può consentire tutto mentre la richiesta non arriva mai al negozio, perché Cloudflare ha risposto prima. Una voce del robots.txt è una richiesta; una regola di Cloudflare è un'imposizione, ed è per questo che le due cose vanno controllate separatamente. Un firewall o una protezione anti-bot del provider di hosting possono filtrare allo stesso modo, e lì il blocco nasce spesso da una regola generica piuttosto che dal nome di un crawler IA.
Se il negozio è dietro Cloudflare, la schermata AI Crawl Control mostra riga per riga quale crawler è stato bloccato. Vale anche come misurazione: un crawler che non compare nell'elenco non ci ha mai provato.
Come arrivano i prodotti nelle risposte di shopping di ChatGPT?
Qui una pagina leggibile non basta più. OpenAI chiede un feed dei prodotti separato, e la sua documentazione dice che l'inserimento dei feed di prodotti in ChatGPT è disponibile al momento per partner approvati, su richiesta. Quindi, quando qualcuno sostiene che un negozio si possa semplicemente collegare a ChatGPT, è bene sapere che non si tratta di un'attivazione in autonomia.
La struttura del feed però è pubblica, e conviene prepararsi, perché si basa sugli stessi dati che chiede Google Shopping. I campi obbligatori sono nove: item_id, title, description, url, brand, seller_name, image_url, availability e price. Il ritmo consigliato è un feed completo al giorno caricato come file, con le modifiche durante la giornata inviate tramite API; i dati sulle promozioni si possono fornire solo tramite API.
Il pagamento resta al commerciante. Secondo la documentazione di OpenAI, lo stato del checkout e l'elaborazione del pagamento avvengono sui sistemi del commerciante, e OpenAI non è il venditore registrato (merchant of record). Il negozio non cede alcuna parte della transazione: diventa solo raggiungibile su un canale in più.
Questo significa che, per un negozio il cui feed Google Shopping non è in ordine, il passo successivo è quel feed, non l'IA. Stessi dati, stessi difetti: marca mancante, prezzo non aggiornato, disponibilità sbagliata. Il nostro modulo Product feed export crea i feed per Google, Facebook e TikTok da un'unica fonte, e il nostro articolo sulla Merchant API spiega cosa è cambiato quest'anno sul fronte Google.
Un negozio ha bisogno di un file llms.txt?
Non per essere mostrato. La documentazione di Google citata sopra dice esplicitamente che non occorre creare file di testo per l'IA, e nessun motore di ricerca o assistente lo indica come condizione. I grandi siti di documentazione, tra cui i siti per sviluppatori di OpenAI e Cloudflare, pubblicano un file del genere perché rende la propria documentazione più facile da leggere con uno strumento IA, ma non è un fattore di ranking o di idoneità.
Il suo aiuto è un altro: il file offre un elenco ordinato di ciò che il negozio contiene, così diventa più prevedibile cosa trova un programma che legge le pagine. Per chi preferisce non aggiornare quell'elenco a mano, il nostro modulo llms.txt generator lo mantiene allineato a prodotti, categorie e pagine informative. L'ordine però non si può invertire: se i crawler sono esclusi o i dati sono vecchi, questo file non aiuta.
Come si misura il traffico dalle risposte IA?
I clic dalle risposte IA di Google compaiono nel report Prestazioni di Search Console, nel tipo di ricerca "Web", insieme al resto dei clic dalla ricerca. Non c'è una riga separata per l'IA, quindi Search Console non può dirti quanti di quei clic arrivino da lì.
L'altra strada sono le proprie statistiche: i visitatori che arrivano dai canali IA portano il referrer di quel canale, per esempio chatgpt.com o perplexity.ai. Conviene impostare per loro un segmento o un report in Google Analytics 4, perché per impostazione predefinita si confondono nel traffico di referral generico. Sul fronte pubblicitario, il nostro modulo ChatGPT Ads misura i risultati delle inserzioni in ChatGPT, dal browser e dal server.
Una cosa che non conviene fare è citare una stima della quota di ordini che arriva dalle risposte IA. Oggi non esistono dati che un negozio possa leggere dai propri strumenti per sostenere un numero del genere.
Cosa conviene fare adesso?
- Apri il
robots.txtall'indirizzo del negozio (/robots.txt) e cercaOAI-SearchBot,GPTBot,PerplexityBoteGoogle-Extended. Se nessuno di questi ha unDisallow, questa parte è a posto. - Chiedi all'hosting, o controlla Cloudflare, se qualche regola blocca i crawler IA. Su Cloudflare lo mostra la schermata AI Crawl Control, crawler per crawler.
- Controlla l'indicizzazione in Search Console, perché una pagina non indicizzata non può comparire nemmeno in una risposta IA. Rientra qui anche un
nosnippetrimasto per errore. - Metti in ordine il feed dei prodotti (prezzo, disponibilità, marca, immagine), perché gli stessi dati servono sia a Google Shopping sia a un feed per ChatGPT.
- Imposta la misurazione in Google Analytics 4 per i referral dai canali IA, così da avere una base di confronto per i prossimi mesi.
Tutto il resto è lavoro sui contenuti, ed è lo stesso lavoro che l'ottimizzazione per i motori di ricerca ha sempre richiesto: nomi dei prodotti precisi, descrizioni vere, attributi compilati, dati strutturati coerenti con la pagina. Non serve alcuna tecnica nuova.
Che cosa cambia il segnale comune per l'addestramento dell'IA nel robots.txt?
Il 30 ottobre 2026 Google ha annunciato che supporterà nel robots.txt un segnale comune con cui un sito può dire in una sola mossa, a più fornitori di IA, se accetta che i propri contenuti vengano usati per l'addestramento. Il segnale nasce dal lavoro del gruppo AIPREF dell'IETF. La documentazione di Google sui crawler indica che si scriverà user-agent: __usage_ai-training e che il supporto è previsto per l'inizio del 2027, insieme a quello di altri fornitori di IA. Fino a quel momento valgono i controlli attuali, quindi oggi nel negozio non c'è nulla da cambiare: basta prendere la decisione.
Secondo l'annuncio il segnale funzionerà così: se un sito rifiuta l'addestramento con il token comune e non indica separatamente Google-Extended, Google intende leggerlo come se Google-Extended fosse stato vietato. I controlli specifici delle singole aziende continuano a funzionare accanto, perciò nello stesso file possono stare un rifiuto ampio e un'eccezione per un fornitore preciso.
La decisione ha due lati. La documentazione di Google afferma che Google-Extended non incide sulla presenza del sito nella Ricerca Google e non è un fattore di ranking, quindi rifiutare l'addestramento non toglie il negozio dai risultati. L'annuncio del 30 ottobre precisa però anche che i siti che consentono espressamente Google-Extended possono comparire nelle risposte e ricevere clic tramite il grounding nelle app Gemini. Chi rifiuta l'addestramento rinuncia anche a quei clic.
Google aggiunge che la proposta è coerente con il codice di buone pratiche dell'Unione europea per i fornitori di modelli di IA per finalità generali, nel quadro del regolamento sull'IA, che riconosce il robots.txt come via principale per esprimere una preferenza leggibile da una macchina. La forma definitiva si discute ancora all'IETF, ma il posto del file è già stabilito.
In PrestaShop il file robots.txt viene scritto dall'amministrazione e la rigenerazione sostituisce l'intero file: la riga aggiunta a mano va persa in quel momento. Un'installazione ha un solo file, quindi un negozio distribuito su più domini non può impostare dall'amministrazione una regola diversa per ciascun dominio. Perché la riga resti, deve scriverla un modulo nel momento della generazione.
Domande frequenti
D: Se blocco GPTBot, sparisco dalle risposte di ChatGPT?
R: No. La documentazione di OpenAI precisa che le impostazioni sono indipendenti: GPTBot raccoglie dati per l'addestramento, mentre la visibilità nella ricerca dipende da OAI-SearchBot. È bloccando quest'ultimo che un sito esce dalle risposte di ricerca di ChatGPT.
D: Bisogna aggiungere markup schema.org per l'IA?
R: Secondo Google non ci sono dati strutturati speciali da aggiungere per questo. Per il markup di prodotto già presente, la condizione è che corrisponda al testo visibile nella pagina.
D: Oggi i miei prodotti si possono comprare dentro ChatGPT?
R: Secondo la documentazione di OpenAI, l'inserimento di un feed dei prodotti è disponibile al momento per partner approvati, su richiesta. Il pagamento avviene sui sistemi del commerciante, e OpenAI non è il venditore registrato.
D: Come faccio a sapere se un crawler IA è mai passato?
R: Dal log di accesso dell'account di hosting, cercando il nome del crawler, oppure dall'elenco di AI Crawl Control su Cloudflare. Un crawler che non compare da nessuna parte non ci ha mai provato.
Fonti: Ricerca Google: funzionalità IA e il tuo sito web, Google: crawler comuni (Google-Extended), OpenAI: Bots, OpenAI Commerce: primi passi (in inglese), OpenAI Commerce: specifiche del feed dei prodotti, OpenAI Commerce: concetti chiave, Perplexity: Bots, Cloudflare: Content Independence Day, Cloudflare: AI Crawl Control, Google Search Central, 2026-10-30, Google: Google-Extended

